
Hello,
Bienvenue dans l’édition #164 de la newsletter DataGen ! 👋
L’agenda de la semaine :
🔍 Zoom sur les 3 chantiers clés d’un Head of Data Science chez DoorDash
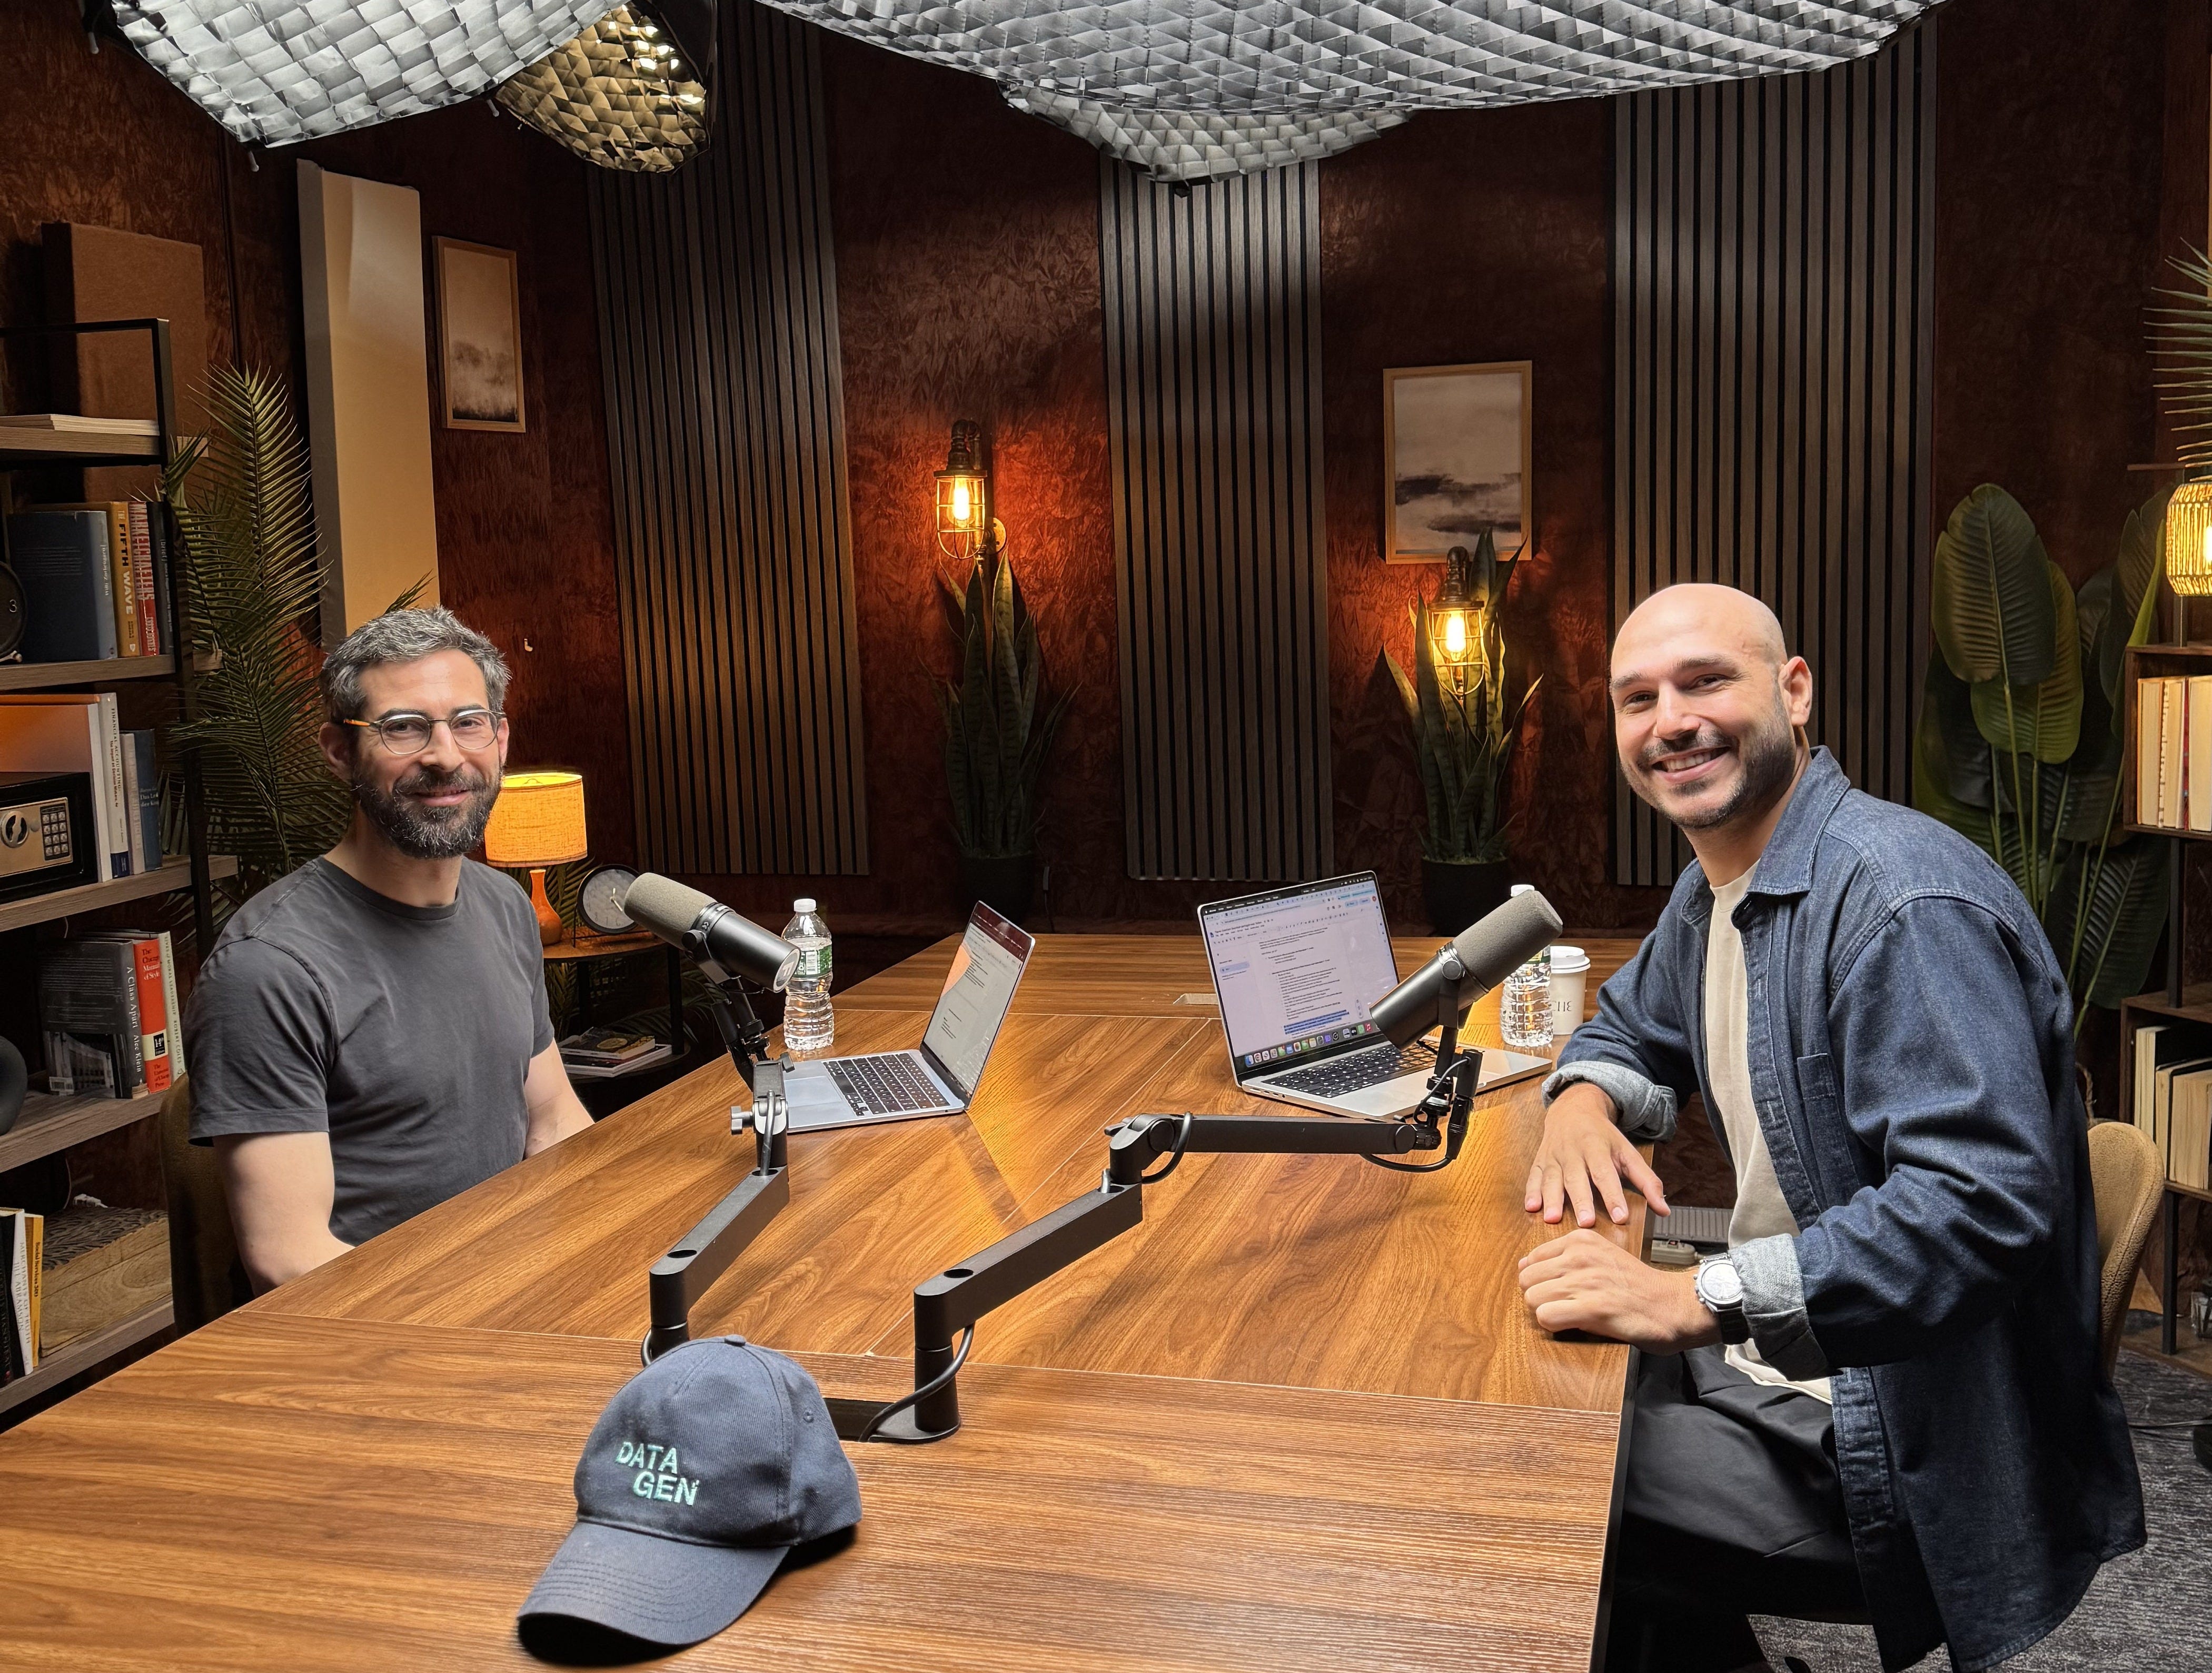
🎙 Le podcast avec Ruben, ex-Head of Data Science de DashPass chez DoorDash
📚 Les ressources recommandées par Ruben
C’est parti !
📢 Comment automatiser ses développements Data & Analytics avec des agents IA ?
C’est la question que j’ai posée à Frédéric Forest, un expert du sujet.
Il est venu nous faire une masterclass dans l’épisode 287.
Il nous explique comment on démarre, avec quels cas d’usage et à quoi ça ressemble lorsqu’on scale. Il nous détaille comment on construit son fameux harnais, les livrables à produire et les risques à anticiper tels que le shadow IT ou la perte de maîtrise au niveau des compétences et des coûts.
Et pour accélérer, Frédéric organise un atelier sur l’agentique le 24 septembre.
Un immense merci à Datatorii de sponsoriser DataGen. ❤️
🔍 Zoom sur les 3 chantiers clés d’un Head of Data Science chez DoorDash - 3 min
Ce zoom est tiré de mon échange avec Ruben, ex-Head of Data Science chez DoorDash, le leader de la livraison de repas aux États-Unis, qui a également racheté Deliveroo et Volt. Ruben a monté l’équipe Data Science dédiée à DashPass, l’offre d’abonnement de DoorDash (l’équivalent d’Uber One).
“Aux États-Unis, DoorDash est le leader incontesté et Uber Eats est 2ème. Au global chez DoorDash, côté data, il y a entre 200 et 250 personnes et il y a 14 personnes dans l’équipe DashPass que j’ai montée.”
Chantier #1 : Recruter et structurer une équipe de 14 Data Scientists spécialisés sur la prise de décision
Quand Ruben arrive, l’équipe Data Science de DashPass compte 3 ou 4 profils, plutôt juniors. L’objectif : monter une équipe plus grosse et beaucoup plus senior.
“Recruter des gens capables d’ajouter vraiment de la valeur à leurs partenaires business, c’est compliqué.”
Les 2 critères qu’il regarde le plus lorsqu’il recrute un Data Scientist :
1) L’intuition produit et business
Les compétences techniques, c’est une condition nécessaire mais pas suffisante. Il faut être capable de se mettre dans les chaussures du client et de comprendre les dynamiques complexes d’une marketplace.
“Ce qui fait vraiment la différence, c’est l’intuition produit et business : c’est la capacité à faire le lien entre la data et le business.”
2) La curiosité et l’excellence technique
Rester à la frontière de ce qui se fait en Data Science, ce n’est pas optionnel, ça fait partie du boulot. Les PMs et les équipes Ops dans les boîtes tech montent aussi en compétences sur la data et sont de plus en plus autonomes : SQL, dashboards, analyses statistiques de base. Pour continuer à apporter de la valeur différenciante en tant que Data Scientist, il faut rester un cran au-dessus.
“Un Data Scientist doit apprendre en continu pour opérer à la limite de ce qu’est la Data Science.”
Chantier #2 : Adopter des méthodologies d’inférence causale pour augmenter l’impact de l’équipe
Qu’est-ce que l’inférence causale ?
Il y a des cas pour lesquels un AB test classique n’est pas réalisable. Par exemple, Netflix ne peut pas proposer des prix différents à ses clients, et de la même façon DoorDash ne peut pas proposer son offre d’abonnement uniquement à certains clients. Le risque peut être trop élevé en termes d’expérience client et de manque à gagner. Et il y a trop de paramètres en jeu pour que l’AB test soit fiable (ex : effets de réseaux).
C‘est là qu’entrent en jeu des techniques plus avancées qu’on qualifie d’inférence causale qui permettent, sans réaliser d’AB tests, de valider dans une certaine mesure l’impact d’actions potentielles (ex : création d’un abonnement, changement de prix…).
Ce sont des méthodologies qui s’appuient sur des modèles statistiques avancés : propensity matching, causal tree, uplift modeling, causal forest…
“Assez rapidement, j’ai demandé à mon équipe d’utiliser ce genre d’approche à chaque fois pour avoir des recommandations plus fines, plus pertinentes, qui généraient plus d’upside pour la boîte. Et aussi parce que lire le résultat d'un AB test, maintenant tout le monde peut le faire.”
Chantier #3 : Redéfinir le rôle du Data Scientist à l’ère de l’IA et de l’agentique
L’IA est en train de transformer le métier du Data Scientist sur 2 axes :
1) Le day-to-day du Data Scientist devient AI-first
Fini les queries à la main, les questions aux collègues sur la définition d’une table ou d’une métrique. Les Data Scientists utilisent l’IA pour toutes les tâches : chercher, structurer, analyser…
2) Les profils PM, Ops ou Marketing deviennent beaucoup plus autonomes
L’IA permet à des profils non Data Scientists d’accéder aux données et de réaliser des analyses en autonomie, y-compris des tests statistiques poussés.
Les Data Scientists peuvent évoluer dans 2 directions :
1) Devenir plus technique et opérer à la frontière de la technologie (ex : inférence causale, biais, hétérogénéité des réponses, effets de réseaux…)
“Même si les PMs et les équipes Ops sont très intelligents, ils n’auront pas forcément la capacité ou le temps de travailler sur ces sujets.”
2) Mettre en place les infrastructures qui permettent à l’IA de fonctionner (ex : semantic & context layers)
“Comment définir le contexte qui permet aux agents IA de comprendre les données et de proposer des réponses fiables.”
🎙 Le podcast avec Ruben, ex-Head of Data Science de DashPass chez DoorDash
On aborde :
Le parcours de Ruben dans la Silicon Valley : de Stanford à DoorDash
Chantier #1 : recruter et structurer l’équipe (cf. zoom)
La différence entre un Data Scientist dans les big tech US et en France
Chantier #2 : adopter des méthodologies d’inférence causale (cf. zoom)
Comment apporter de la valeur en tant que Data Scientist
Chantier #3 : Redéfinir le rôle du Data Scientist à l’ère de l’IA (cf. zoom)
Son nouveau rôle de Head of Data chez Nourish, une licorne US
Ce qui fait progresser un Data Scientist selon Ruben
“La curiosité et continuer à apprendre, c’est vraiment impératif. Ensuite, il faut constamment remettre en question le status quo et se demander comment je peux faire évoluer mon métier, mon approche et mes collègues.”
Liens vers l’épisode : Apple Podcasts | YouTube | Spotify
📚 Les ressources recommandées par Ruben
Le podcast Stratechery de Ben Thompson
“Il propose des analyses extrêmement fines sur l’IA et la Tech qui permettent de comprendre ce qui se passe au niveau global (coûts des tokens, valorisations, pénuries de puces…).”
Le podcast Capitalism d'un professeur de l'Université de Chicago
“C’est un podcast sur l’économie où il interviewe pas mal de prix Nobel. Les problématiques sont générales. J’aime beaucoup.”
Le livre “The Signal and the Noise” de Nate Silver
“Un livre sur l’utilisation de la data à travers les âges : Seconde Guerre mondiale, baseball, poker… c’est vraiment un exposé très intéressant.”
Le livre “Chaos Monkeys” de Antonio García Martínez
“Un récit des années folles de Facebook et de la Silicon Valley. Il décrit le bronx absolu qu’il y avait dans ces boîtes-là à l’époque, les excès, le chaos, c'est assez drôle.”